Pruebas tipo Turing: la brecha entre humanos e IA se angosta en lenguaje y visión
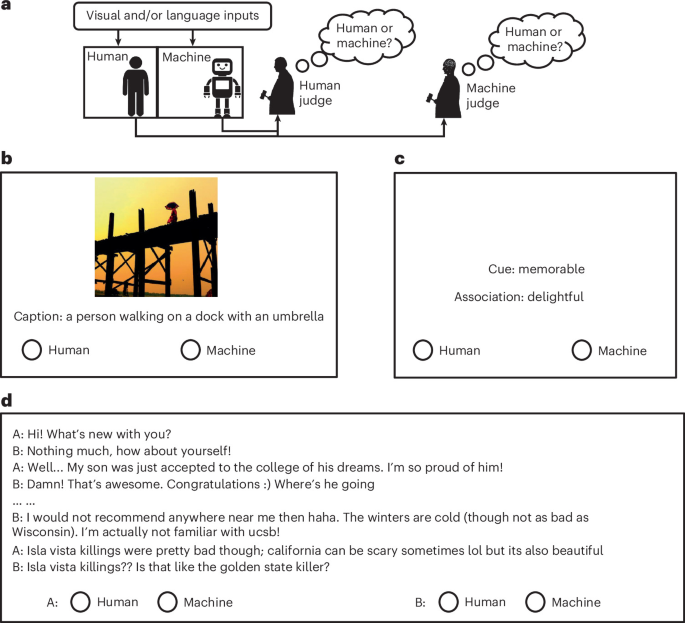
Comparó 636 humanos con 37 agentes en seis tareas y corrió 72.191 pruebas con 1.916 jueces. Los modelos se acercan a pasar por humanos en lenguaje y visión; es benchmark, no evidencia de comprensión.
Nature Human Behaviour · 26/10